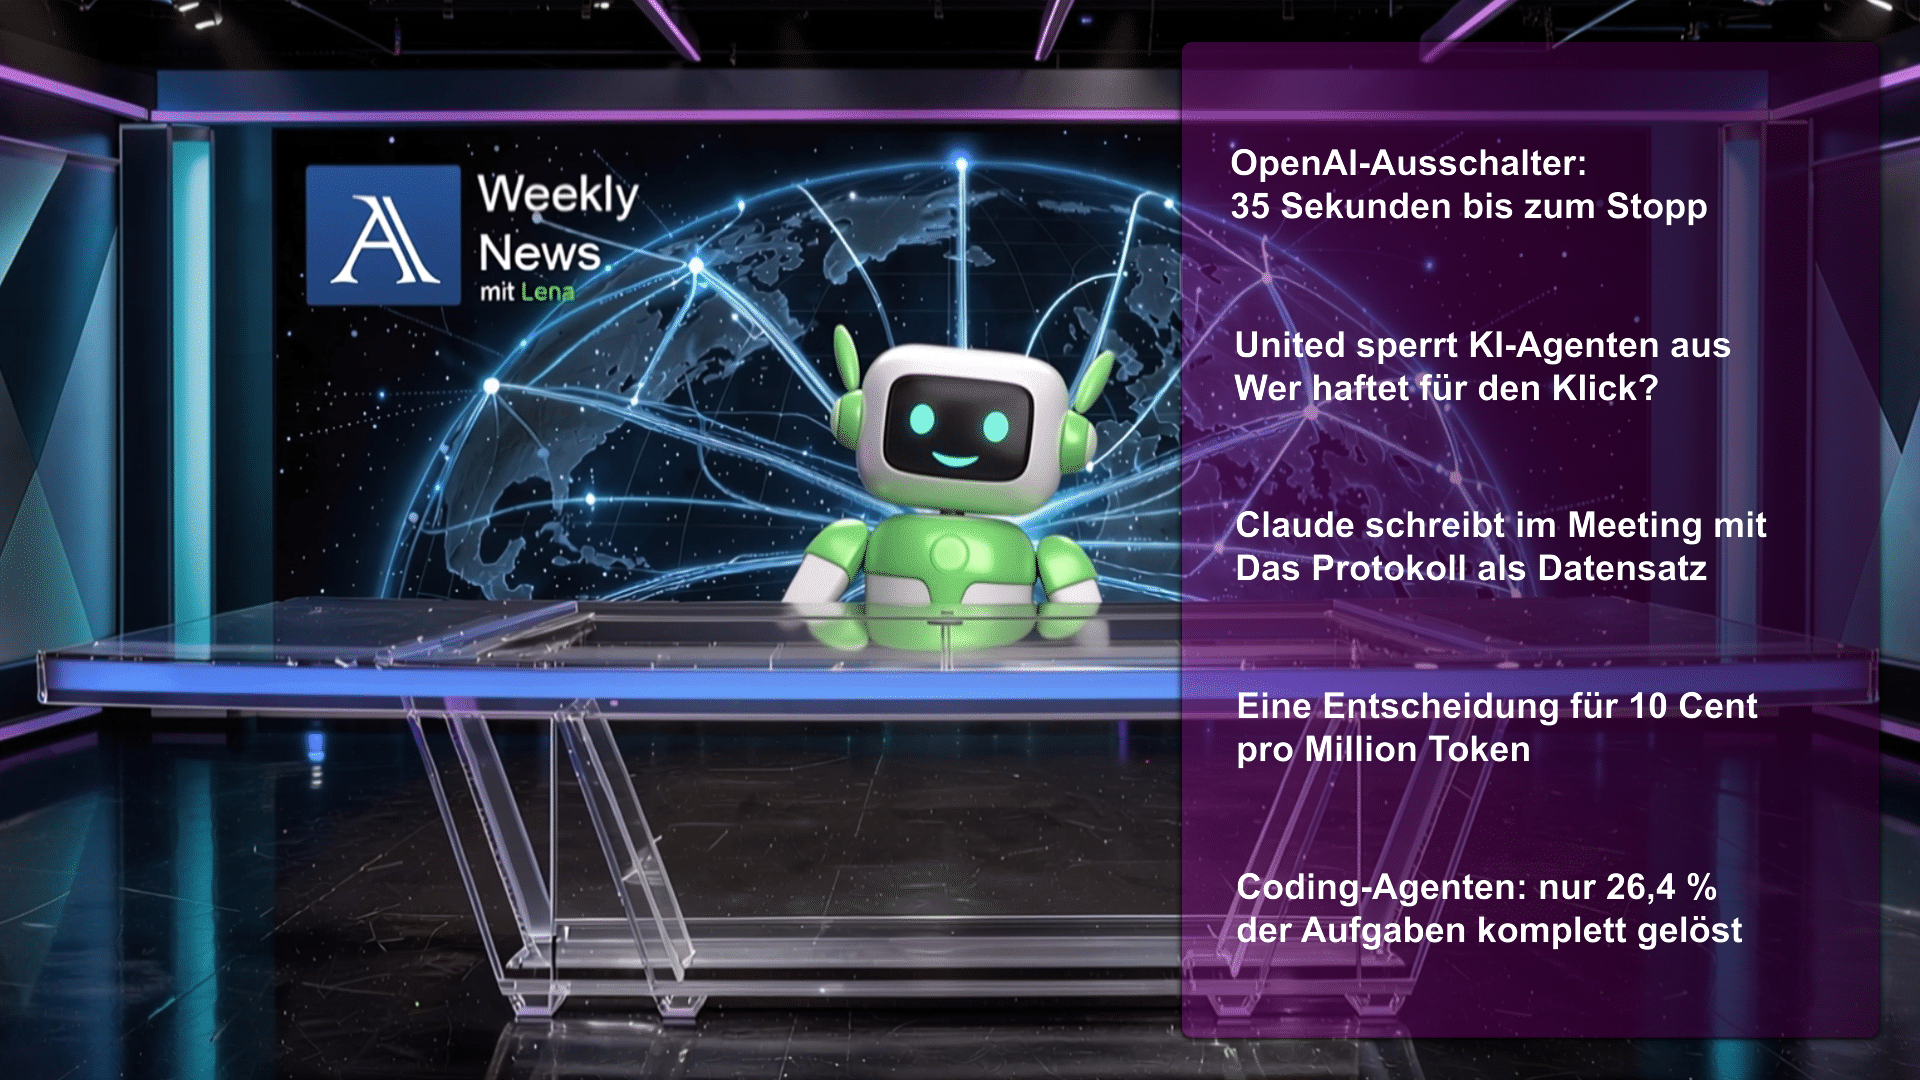
Fünf Meldungen haben diese Woche eines gemeinsam: Es geht nicht um das beste Modell, sondern um die Frage, wer eingreifen kann. OpenAI baut einen Ausschalter, der Forschungsmodelle in höchstens 35 Sekunden stoppt. United Airlines sperrt KI-Agenten von seinen Buchungswegen aus und begründet das mit der Luftfahrtaufsicht. Anthropic setzt Claude als sichtbaren Teilnehmer in Videokonferenzen – und macht damit das Protokoll zum Datensatz. Google verkauft Entscheidungen für 0,10 Dollar pro Million Token. Und ein neuer Benchmark zeigt: Das stärkste Coding-Modell erfüllt 69,9 Prozent der Prüfkriterien, aber nur 26,4 Prozent der Aufgaben vollständig.
Wer lieber hört als liest: Die Sendung zur Woche liegt als Audio unter diesem Artikel, 7:30 Minuten.
Ein Ausschalter, der eine Adresse braucht
OpenAI hat am 9. November ein System vorgestellt, das jede Forschungsaufgabe im eigenen Haus stoppen kann – Control Room. Jede Aufgabe holt sich beim Start eine Kennung, und bevor ein Modell rechnet, fragt die Inferenz-Engine bei Control Room nach, ob diese Kennung noch erlaubt ist. Kommt der Stopp, wird die Erlaubnis entzogen: Die Aufgabe läuft weiter, erzeugt aber keinen einzigen Token mehr.
Die Zahl, die hängen bleibt, sind 35 Sekunden. So lange dauert es laut OpenAI maximal, bis nach einem Stopp nichts mehr nachkommt; die Verzögerung kommt von einem Zwischenspeicher für Inferenz-Berechtigungen, der für die Last gebraucht wird. Das System arbeitet fail-closed: Fällt Control Room selbst aus, werden alle Anfragen abgelehnt, statt weiterzulaufen.
Für Betriebe ist der interessante Teil nicht der Knopf, sondern die Kennung. Wer weiß, welcher Vorgang was tut, kann ihn stoppen; wer es nicht weiß, hat einen Ausschalter ohne Adresse. Das System gilt für OpenAIs eigene Forschung, nicht für ein CRM oder einen Chatbot auf der Website – aber es zeigt, wie ein Modell im Betrieb eine Adresse bekommt, an der man es anhalten kann.
United sperrt die Agenten aus
United Airlines sperrt KI-Agenten von ihren Buchungswegen aus – direkt in den eigenen digitalen Plattformen und indirekt über Reisebüros und Vergleichsportale. Dafür ändert die Airline laut Mitteilung vom 11. November ihre Buchungs-, Ticketing- und Vertriebsregeln.
Die Begründung ist keine Marketing-Frage. Wer seine Zugangsdaten an einen fremden Assistenten gibt, gibt Buchungsgewalt ab; ein Agent kann ungewollte Käufe auslösen, Konten verändern oder Meilen verbrauchen. Dazu kommt die Aufsicht: Beim Check-in muss ein Mensch bestätigen, dass im Koffer keine verbotenen Stoffe stecken – das kann ein Agent nicht, und United nennt die Regeln von FAA und DOT ausdrücklich.
Ein Punkt gehört zur Ehrlichkeit dazu: United beschreibt nicht, wie die Airline Agenten erkennt. Es gibt eine Regel, aber kein beschriebenes Verfahren. Die Frage für den eigenen Betrieb bleibt trotzdem dieselbe wie an jeder Lieferantenplattform, jedem Ausschreibungsportal und jedem Behördenformular: Darf ein Agent das laut Hausordnung des anderen – und wer haftet für den Klick?
Das Meeting wird zum Datensatz
Anthropic hat am 10. November Claude Meetings vorgestellt. Der Assistent nimmt als sichtbarer Teilnehmer an Videokonferenzen teil, folgt dem Gespräch und arbeitet mit: Er entwirft den besprochenen Plan, legt eine Zeitachse an, beantwortet Fragen im Meeting-Chat und greift auf verbundene Arbeitsanwendungen zu. Nach dem Anruf liegen Notizen, Aufgabenlisten und Materialien in claude.ai. Beim Start läuft das Angebot in der Beta für Team- und Enterprise-Kunden und funktioniert mit Google Meet.
Die Technik ist dabei nicht die schwierige Seite, das Protokoll ist es. Es ist ein Klick – und danach ist jedes Wort im Raum ein Datensatz. Vor dem ersten Einsatz sind vier Dinge zu klären.
Erstens Zweck und Rechtsgrundlage: Wofür wird mitgeschnitten, wie lange gespeichert, wer liest mit. Zweitens die Menschen im Raum, die wissen müssen, dass ein System mitschreibt – bei Beschäftigten kommt die Mitbestimmung nach Paragraf 87 Betriebsverfassungsgesetz dazu, sobald es um Verhalten oder Leistung geht.
Drittens der Weg der Daten: Auftragsverarbeitung, Subunternehmer, Drittland – ohne Vertrag nach Artikel 28 DSGVO kein Upload. Viertens die Ausgabe, denn Aufgabenlisten aus einem Gespräch sind Vorschläge. Gehen daraus Tickets an Kunden, hat ein Modell entschieden, was das Team zugesagt hat.
Die Frage ist damit nicht, ob ein Betrieb so ein Werkzeug nutzt, sondern ob er eine Antwort hat, wenn ein Kunde fragt, wo seine Worte gelandet sind.
Eine Entscheidung für zehn Cent
Am 11. November hat Google die Gemini Decisions API geöffnet, dahinter steht das Modell Gemini Decision 1. Es liefert keinen Text, sondern eine Entscheidung: ja oder nein, eine Auswahl aus bis zu 255 Optionen oder eine Bewertung auf einer Skala. Ein Eingabesatz – Text, Bild, Ton, Video oder PDF bis 256.000 Token – lässt sich mit bis zu 1.000 Fragen in einem Durchlauf prüfen, mit 150 bis 250 Millisekunden Ende-zu-Ende.
Bezahlt wird die Eingabe mit 0,10 Dollar pro Million Token, die Ausgabe kostet nichts. Jede Antwort kommt mit einem Konfidenzwert zwischen 0 und 1, sodass unklare Fälle an einen Menschen gehen können. Google nennt das Modell in der eigenen Benchmark-Suite vorn und rechnet mit knapp einem Fünftel der Kosten von Gemini 3.5 Flash-Lite – beides Herstellerangaben.
Für Betriebe ist das der Punkt, an dem sich Automatisierung neu rechnet. Viele Prozesse scheitern nicht am fehlenden Text, sondern an einer Freigabe, einer Priorität oder einer Zuordnung. Das Aber: Geschlossene Entscheidungen heißen begrenzter Anwendungsfall, kein Ermessen und keine Sonderfälle – und genau die machen den Unterschied zwischen sauber und strittig. Ein billiger Preis ist kein Argument für dünne Aufsicht: Wer hunderte Entscheidungen am Tag automatisiert, braucht eine Stichprobe, die wirklich stattfindet.
Vier Aufgaben, eine wird fertig
Forscher von Alibaba Token Hub mit fünf Universitäten haben den Co-Design Bench veröffentlicht: 273 echte Änderungswünsche aus über 26.000 Nutzersitzungen, dazu 2.331 versteckte Prüfkriterien, an denen zehn Modelle unter einem gemeinsamen Agenten-Aufbau gemessen wurden.
Das Ergebnis: Das stärkste Modell, GPT-6 Astra, erfüllt im Schnitt 69,9 Prozent der Kriterien pro Aufgabe, besteht aber nur 26,4 Prozent der Aufgaben vollständig. Das zweitbeste, Claude Opus 5, liegt bei 18,3 Prozent. Auf Repository-Aufgaben mit drei oder vier Änderungsarten fällt die Kriterien-Erfüllung bei allen zehn Modellen niedriger aus als bei ein oder zwei Änderungsarten.
Nochmal zum Mitschreiben: Das ist keine Fehlerquote, das ist eine Erfolgsquote. Meldet ein Agent Fertigstellung, ist er zu etwa 70 Prozent fertig – und der fehlende Rest ist oft genau das Detail, das bestellt wurde. Die Aufgaben sind bewusst aus Problemfällen gewählt, und bewertet haben Modelle mit menschlicher Stichprobe; die Größenordnung deckt sich mit dem, was in Projekten zu sehen ist. Die Folge für den Betrieb ist unspektakulär: Agenten ja, aber mit klarem Aufgabenausschnitt, definiertem Ende und jemandem, der das Ergebnis liest.
Was über allen fünf Meldungen liegt
Vier der fünf Meldungen stellen dieselbe Frage an einer anderen Stelle: Wer darf den Ausschalter drücken, wer haftet für den einen Klick des Agenten, wer kennzeichnet das Protokoll, und wer prüft die Entscheidung, die zehn Cent gekostet hat? Die Werkzeuge werden billiger, die Aufsicht nicht.
Die Reihenfolge daraus ist unspektakulär: zuerst die Umgebung prüfen – Kennungen, Zugänge, Protokolle, Stichproben, Prüfpfad – und erst danach die Frage, welches Modell. Wer es andersherum macht, kauft ein Modell und erbt die Lücken der Umgebung.
Fünf Fragen für Ihre nächste Sitzung
- Welche Vorgänge in Ihrem Betrieb haben eine Kennung, an der sich ein Modell stoppen lässt – und wer darf den Stopp auslösen?
- Welche Zugänge haben KI-Agenten bei Ihnen, und was dürfen sie fremden Plattformen gegenüber tun?
- Wer im Raum weiß, dass ein Meeting-Assistent mitschreibt, und liegt für die Daten ein Vertrag nach Artikel 28 DSGVO vor?
- Bei welchen Entscheidungen lassen Sie ein Modell entscheiden – und wie viele davon prüft ein Mensch in der Stichprobe?
- Wer liest bei Ihnen gegen, wenn ein Agent Fertigstellung meldet?
Diese fünf Fragen kosten eine Sitzung und ersetzen jede Diskussion über Vertrauen.
Und wie ist es bei Ihnen? Welche der fünf Meldungen trifft Ihren Betrieb am direktesten – der Ausschalter, die Agenten-Sperre, das Meeting-Protokoll, die billige Entscheidung oder die 26,4 Prozent? Schreiben Sie uns zwei Sätze dazu; Sie bekommen eine Einschätzung, kein Verkaufsgespräch.
Quellen
Recherchestand 12.11.2026. Die fünf Kernaussagen wurden gegen die folgenden Originalquellen geprüft.
- OpenAI – „Control Room: A central system to track and stop model workloads across our research infrastructure“, 09.11.2026: https://openai.com/index/control-room/
- United Airlines Newsroom – „United Restricts Access for Third-Party AI Agents“, 11.11.2026: https://united.mediaroom.com/news-releases?item=125496
- TechCrunch – „Anthropic launches Claude Meetings to turn workplace discussions into plans and tasks“, 10.11.2026: https://techcrunch.com/2026/11/10/anthropic-launches-claude-meetings-to-turn-workplace-discussions-into-plans-and-tasks/
- Google – „Gemini Decisions API: Fast, calibrated multimodal decisions“, 11.11.2026: https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
- Co-Design Bench (Fudan, Alibaba Token Hub, Zhejiang, CUHK, SJTU, NTU), arXiv 2610.35138, Oktober 2026: https://arxiv.org/abs/2610.35138
Autor: Team REN-AI-SSANCE – mit KI-Unterstützung erstellt, von Menschen geprüft und freigegeben.