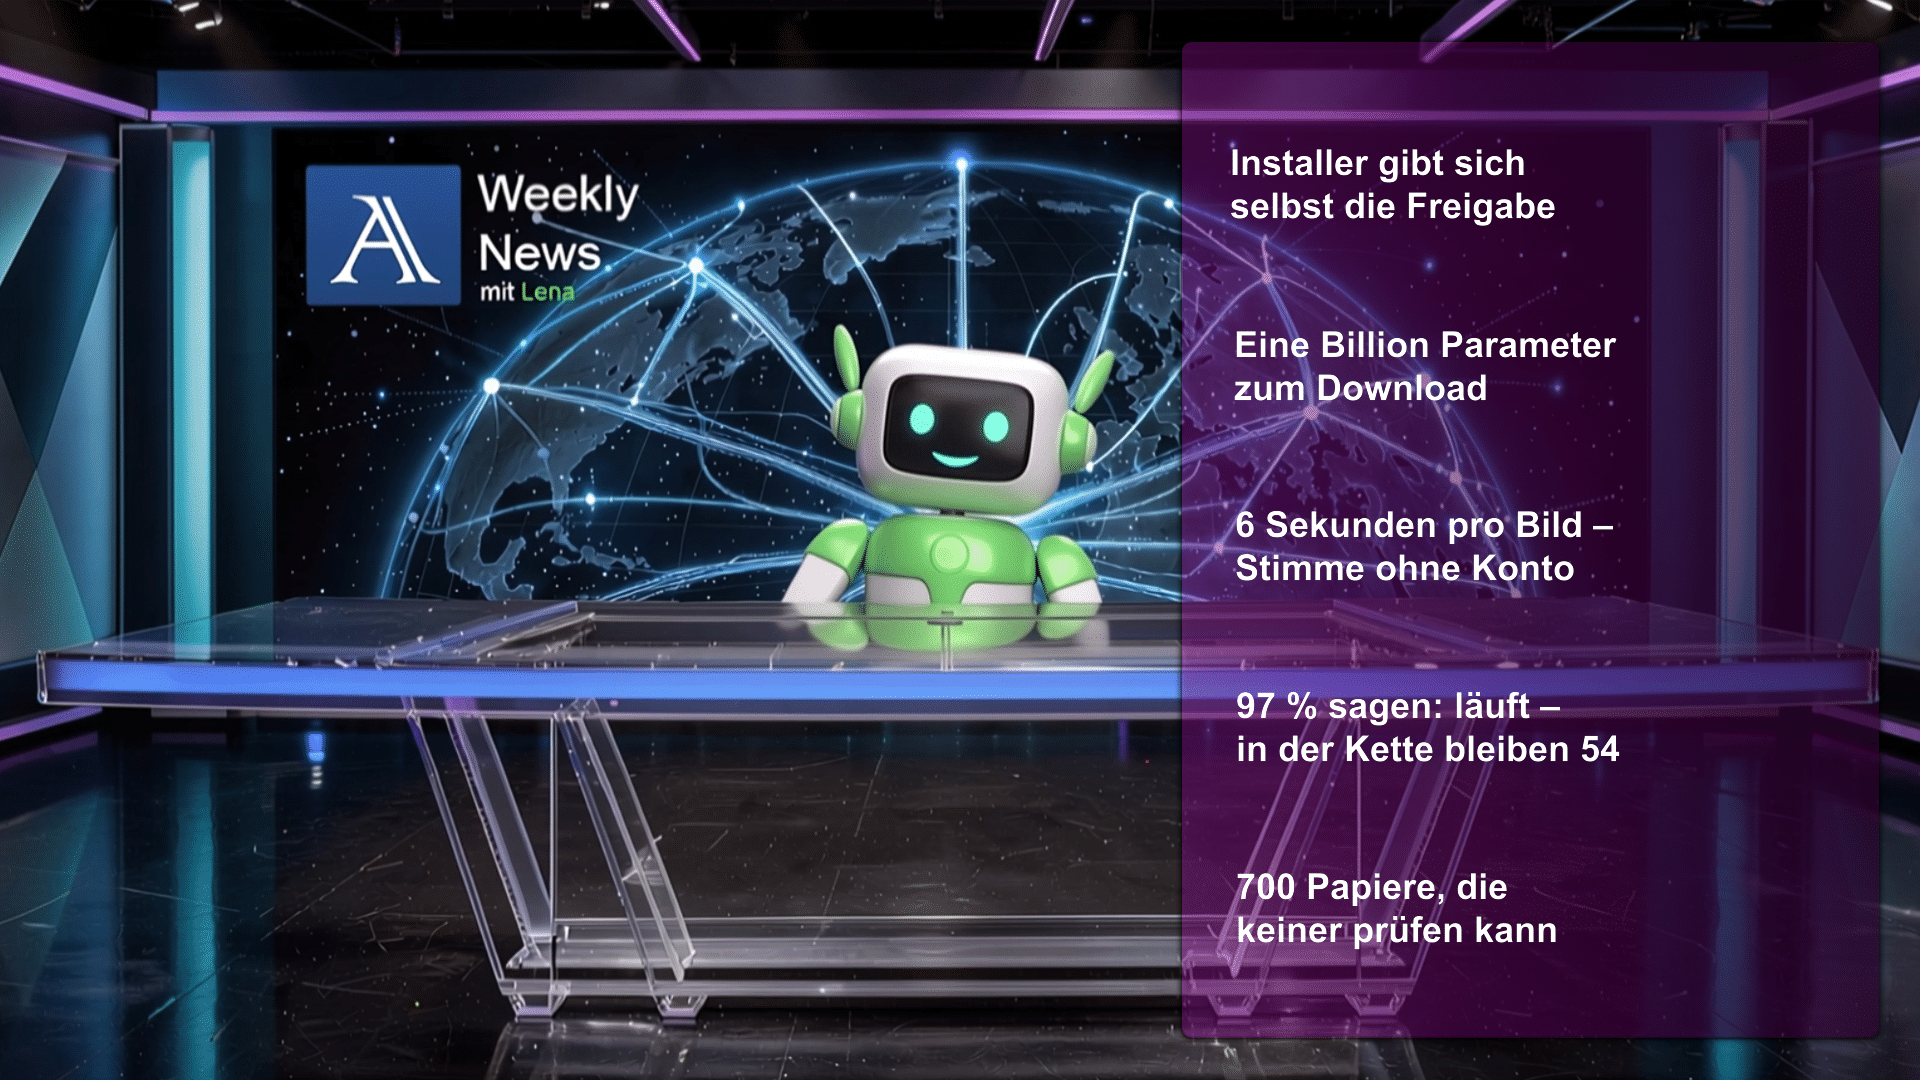
Fünf Meldungen haben diese Woche den Ton angegeben, und in keiner geht es darum, welches Modell vorn liegt. Ein Installer trägt zwei Coding-Agenten Plugins ein, die niemand freigegeben hat, und bestätigt seinen eigenen Start-Hook gleich selbst. Mistral legt eine Billion Parameter offen. Auf einer 24-Gigabyte-Grafikkarte entsteht ein Bild in sechs bis neun Sekunden, eine geklonte Stimme braucht dafür kein Konto. 97 Prozent der CEOs melden, ihre KI-Initiativen liefen wie erwartet – in einer Kette aus zwanzig Schritten bleiben davon 54 Prozent. Dazu 700 Forschungsarbeiten, die niemand prüfen kann. Über allen fünf liegt dieselbe Frage: Wer kontrolliert am Ende – der Installer, der Hoster, der Prüfer oder der Mensch am Ausschalter?
Wer lieber hört als liest: Die Sendung zur Woche liegt als Audio unter diesem Artikel, 7:12 Minuten.
Der Installer, der sich selbst die Freigabe gibt
Ein Entwickler öffnet seine Postman-App in Version 12.33.4, und danach tragen zwei Coding-Agenten Plugins, die er nie freigegeben hat: Claude Code und Codex. Das war kein Klick, sondern ein Update, das laut Postmans eigenem Protokoll als Nachinstallation für bestehende Nutzer durchlief. Der Vorgang ist seit dem 25. Oktober im GitHub-Issue #14370 dokumentiert, The New Stack hat ihn am 3. November aufgegriffen.
Der unangenehme Teil ist nicht die Installation, sondern die Freigabe. Der Installer hat in Codex einen Start-Hook eingetragen und diesen gleich selbst als vertrauenswürdig bestätigt. Diese Bestätigung ist normalerweise Ihre Aufgabe, denn ein Start-Hook gibt dem Agenten bei jedem Start Anweisungen mit – in diesem Fall die, vor jeder größeren API-Aufgabe zuerst Postmans Anleitung zu laden. Ein Datenabfluss ist nicht belegt, und am 5. November hat Postman angekündigt, die Änderung zurückzunehmen.
Zurücknehmen heißt allerdings nicht aufräumen: Was installiert ist, bleibt liegen. Für Betriebe ist das die eigentliche Lehre dieser Meldung, denn die Angriffsfläche ist nicht das Modell, sondern die Kette aus Werkzeugen, Hooks und MCP-Verbindungen. Prüfen Sie deshalb, welche Hooks und MCP-Server in Ihren Agenten eingetragen sind, ordnen Sie jede Freigabe einem Menschen zu, und lesen Sie beim Deinstallieren die Konfiguration, statt dem Knopf zu glauben.
Eine Billion Parameter zum Download
Am 29. Oktober hat Mistral die Gewichte von Mistral Large 4 freigegeben: 1,05 Billionen Parameter, davon 52 Milliarden gleichzeitig aktiv, trainiert auf europäischer Infrastruktur. Die Lizenz ist eine modifizierte MIT. Sie dürfen das Modell nutzen, verändern und kommerzialisieren – mit einer Bedingung: Wer es als eigenen Dienst verkauft, braucht vorher eine Freigabe von Mistral.
Für Sie als Anwender ist das nebensächlich, für Ihren Hoster nicht. Offene Gewichte sind nicht dasselbe wie Open Source, und eine Billion Parameter laufen nicht auf dem Rechner unter Ihrem Schreibtisch. Wer selbst hosten will, braucht Rechenknoten, Monitoring und Updates – also einen Betrieb statt eines Downloads. Alle Leistungszahlen bleiben dabei Herstellerangaben.
Die spannendere Zahl für den Mittelstand steht woanders: 0,70 Dollar für die Eingabe, 0,07 Dollar für zwischengespeicherte Eingaben und 2,10 Dollar für die Ausgabe pro Million Tokens. Wenn ein offenes Modell dieser Klasse mitspielt, geraten die Cloud-Preise unter Druck – und die Frage, ob Sie das auch selbst können, wird von einer Glaubensfrage zu einer Rechnung.
Sechs Sekunden pro Bild, eine Stimme ohne Konto
Auf einer RTX 4090 mit 24 Gigabyte, unter Windows, ohne Konto und ohne Cloud braucht FLUX 3 Image Klein für ein Megapixel zwischen 6 und 9 Sekunden. Der Vorgänger lag bei 94 Sekunden und scheiterte an Umlauten; heute liest die Texterkennung Ü, Ä und Ö sauber aus dem Bild. Das ist unsere eigene Messung vom 29. Oktober, kein Benchmark aus einer Pressemitteilung.
Die Rechnung dazu ist öffentlich: Beim Cloud-Dienst kostet ein Bild zwischen 0,008 und 0,036 Dollar. Bei Serien lohnt lokal, bei einzelnen Motiven der Dienst – damit ist die Frage kaufmännisch und nicht ideologisch. Bei der Stimme klont Qwen3-TTS aus 41 Sekunden Referenzmaterial eine Stimme mit einer Wortfehlerrate von null, und eine Minute Text braucht dafür knapp drei Minuten Rechenzeit. Gemessen haben wir das am 17. Oktober.
Zwei Dinge gehören dabei auseinandergehalten, denn lokal ist eine Eigenschaft der Verarbeitung und nicht des Zwecks. Eine DSGVO-Garantie ist damit nicht verbunden, und die Kennzeichnung nach Artikel 50 des EU AI Act trifft Sie als Betreiber – also den, der veröffentlicht. Die Gegenprobe dauert zwei Minuten: Rechner vom Netz, Text sprechen lassen, und was weiterläuft, ist lokal.
97 Prozent sagen: läuft – in der Kette bleiben 54
Im CEO Outlook 2026 von EY Schweiz (19. März 2026) sagen 97 Prozent der befragten CEOs, ihre KI-Initiativen erfüllten die Erwartungen oder übertrafen sie. Fast die Hälfte des Codes auf GitHub war Ende 2025 mit KI-Hilfe geschrieben.
Im selben Papier steht der Satz, der in keiner Pressemitteilung auftaucht: Was in einer Demonstration überzeugend wirkt, ist nicht dasselbe wie ein zuverlässiger Betrieb. Der Grund ist Mathematik, denn in einer Kette aus mehreren Agenten multiplizieren sich die Schwankungen. Aus 97 Prozent pro Schritt werden bei zehn Schritten 74, bei zwanzig nur noch 54.
Um es klar zu sagen: Die 97 Prozent sind eine Selbstauskunft, das Sample kommt aus der Schweiz, und EY verkauft die Beratung dazu. Die Richtung stimmt trotzdem, denn der größte Aufwand liegt nicht im Modell, sondern in Sicherheit, Testumgebungen und Vorfallmanagement. Trennen Sie Test und Produktion, legen Sie fest, wer einen Alarm bearbeitet, und schreiben Sie auf, was der Agent nicht darf.
700 Papiere, die keiner prüfen kann
Am 1. November erschien auf Terence Taos Blog ein Gastbeitrag von Frank Calegari: „Mathematics has changed, let’s act like it“. Auslöser war OpenAIs Veröffentlichung von über 700 Forschungsarbeiten aus der Mathematik am 6. Oktober.
Sein Punkt ist eine Lücke, nicht der Hype. Zwischen der Fähigkeit, einen Beweis zu produzieren, und der Fähigkeit, ihn zu verstehen, entsteht eine Kluft. Knapp wird dadurch nicht das Lösen, sondern das Auswählen – also die Frage, welches Problem sich lohnt und wer anderen erklärt, was gefunden wurde.
Ein Punkt gehört hier zur Ehrlichkeit dazu: Der Beitrag ist laut Fußnote selbst mit KI konvertiert worden, und diese 700 Papiere lassen sich nicht prüfen, nur lesen, was jemand darüber schreibt, der es kann. Für Ihren Betrieb heißt das: Prüfbarkeit ist keine mathematische Frage, sie ist eine Anforderung an den Ablauf. Stichproben, eine zweite Quelle, ein Zweiter, der gegenliest. Ein Ergebnis, das niemand prüfen kann, ist keine Arbeitserleichterung, sondern eine Wette.
Was über allen fünf Meldungen liegt
Um das Modell allein geht es diese Woche in keiner der fünf Meldungen. Viermal steht dieselbe Frage an einer anderen Stelle: Wer kontrolliert den Installer, der Plugins nachträgt und eine Freigabe an sich selbst vergibt? Wer haftet beim Hoster, wenn offene Gewichte erst durch einen Dienst entstehen? Wer kennzeichnet das Bild, das lokal auf Ihrer Grafikkarte gerechnet wurde? Und wer liest gegen, wenn ein Ergebnis niemand mehr prüfen kann?
Unsere Reihenfolge daraus ist unspektakulär und in dieser Woche fünfmal aufgegangen. Zuerst die Umgebung prüfen – Hooks, Lizenzen, Kennzeichnung, Testreihen, Prüfpfad. Erst danach die Frage, welches Modell. Wer es andersherum macht, kauft ein Modell und erbt die Lücken der Umgebung.
Fünf Fragen für Ihre nächste Sitzung
- Welche Hooks und MCP-Server sind in Ihren Agenten eingetragen – und wer hat jede einzelne Freigabe erteilt?
- Verkaufen Sie ein offenes Modell als Dienst? Dann steht die Lizenzfrage vor der technischen.
- Wissen Sie bei jedem Bild und jeder Stimme, ob sie lokal oder in der Cloud entstanden sind – und wer nach Artikel 50 kennzeichnet?
- Rechnen Sie für eine Kette aus mehreren Agenten mit einem anderen Erwartungswert als für den einzelnen Schritt?
- Wer liest bei Ihnen gegen, wenn ein Ergebnis niemand mehr prüfen kann?
Diese fünf Fragen kosten eine Sitzung und ersetzen jede Diskussion über Vertrauen.
Und wie ist es bei Ihnen? Welche der fünf Meldungen trifft Ihren Betrieb am direktesten – der Installer, der sich selbst die Freigabe gibt, die Billion Parameter zum Download, die 54 Prozent in der Kette oder die 700 Papiere, die keiner prüfen kann? Schreiben Sie uns zwei Sätze dazu; Sie bekommen eine Einschätzung, kein Verkaufsgespräch.
Quellen
Recherchestand 5.11.2026, Redaktionsschluss 7.11.2026. Die fünf Kernaussagen wurden gegen die folgenden Originalquellen geprüft. Angaben aus der Tagesberichterstattung, die nicht in der Sendung vorkommen, haben wir nicht übernommen.
- Postman — GitHub Issue #14370 „[SEVERE] Desktop auto-installs Codex/Claude plugins; installer attempts to trust its own startup hook“, 25.10.2026: https://github.com/postmanlabs/postman-app-support/issues/14370
- The New Stack — Bericht zum Postman-Plugin in Claude Code und Codex, 03.11.2026: https://thenewstack.io/postman-plugin-coding-agents/
- Mistral AI — „Mistral Large 4 (Le Chonk) is now open weight“, 29.10.2026: https://mistral.ai/news/mistral-large-4-oss/
- Eigene Messungen Bild (29.10.2026) und Stimme (17.10.2026), Modell- und Lizenzangaben: Black Forest Labs — FLUX 3 Image Klein, 15.10.2026: https://bfl.ai/blog/flux-3-image-klein · Lizenz: https://bfl.ai/licensing · EU AI Act, Artikel 50: https://artificialintelligenceact.eu/article/50/
- EY Schweiz — „AI Trends 2026″ mit CEO Outlook 2026 (97 Prozent), 19.03.2026: https://www.ey.com/en_ch/newsroom/2026/03/ai-trends-2026-between-sovereignty-agent-economy-and-regulatory-turning-point
- Frank Calegari — „Mathematics has changed. Let’s act like it“, Gastbeitrag auf Terence Taos Blog, 01.11.2026 (enthält den Verweis auf OpenAIs Veröffentlichung vom 06.10.2026): https://terrytao.wordpress.com/2026/11/01/mathematics-has-changed-lets-act-like-it/
Autor: Team REN-AI-SSANCE – mit KI-Unterstützung erstellt, von Menschen geprüft und freigegeben.