Am 15.10.2026 hat Black Forest Labs FLUX 3 Image Klein als offene Gewichte veröffentlicht – 5,6 Milliarden Parameter für Text-zu-Bild, Bildbearbeitung per Anweisung und mehrere Referenzbilder in einem einzigen Gewichtssatz [1][2]. Wir setzen es seit dem ersten Tag selbst ein: lokal, über ComfyUI, auf einer Maschine im eigenen Netz, ohne Cloud und ohne Abrechnung je Bild. Dieser Text ist deshalb kein Produktbericht, sondern ein Werkstattbericht. Drei Bilder aus unserer eigenen Produktion zeigen, was das Modell an diesem Tag geleistet hat – deutsche Schrift im Bild buchstabengetreu inklusive Umlaut, eine Szene, in der drei Objekte an ihren Plätzen stehen sollen, und eine Makroaufnahme von Händen. Unter jedem Bild steht der Prompt wörtlich, mit dem es entstanden ist. Dazu kommen die Zahlen, die vor jeder Anschaffung stehen: 5,8 GB Modellgröße gegen 31 GB gemessene Grafikspeicherspitze, 8 GB laut Hersteller nur für eine Quantisierung bei einer Million Pixel, und eine Lizenz, die präziser gelesen werden muss als ihr Ruf. Der wichtigste Satz vorweg: Die Dateigröße eines Modells ist nicht sein Speicherbedarf [4].
Dieser Text beantwortet drei Fragen in dieser Reihenfolge: Was das Modell kann, was es auf welcher Maschine braucht und was die Lizenz erlaubt – und wofür es sich lohnt und wofür ausdrücklich nicht. Alle Angaben stammen aus Quellen, die am 15.10.2026 abgerufen wurden; eigene Messungen sind als solche gekennzeichnet, und wo eine Zahl für eine Entscheidung fehlt, steht das als Lücke im Text statt als Schätzung.
Warum wir dieses Modell selbst einsetzen
Wir haben unser bisheriges Bildmodell am 15.10.2026 abgelöst – zugunsten eines Modells mit einer Lizenz, die Auflagen hat. Das ist eine bewusste Entscheidung und keine Modewelle, denn der Weg dahin läuft bei uns immer gleich: erst Lizenz prüfen, dann Zweck klären, dann Modell wählen. Das Ergebnis dieser Prüfung steht weiter unten im Detail; die Kurzfassung lautet, dass unsere eigene Content-Produktion als Qualifying User von der Lizenz gedeckt ist, während Produktverkauf und Weitergabe der Gewichte es nicht sind.
Was sich im Betrieb geändert hat, ist messbar. Ein Bild in der Größe unserer Beitragsserie (1664 × 928 Pixel) entsteht in 6,2 Sekunden, ein Artikelbild in 1920 × 1120 in 12,2 Sekunden – je 16 Schritte, in der int8-Quantisierung, auf einer Karte mit 24 GB Grafikspeicher in unserem Netz [15]. Deutsche Schrift im Bild war bislang der Punkt, an dem wir Überschriften grundsätzlich im Layout gesetzt und nicht generiert haben. Genau diesen Punkt haben wir neu getestet, mit dem Ergebnis, das in Beispiel 1 steht.
Der Aufhänger ist also nicht die Ankündigung, sondern der Einsatz. Und weil das Modell auf unserer Maschine läuft, können wir eine Frage beantworten, die in Anbietertexten offenbleibt: Was passiert, wenn man es tatsächlich benutzt.
Was das Modell ist
| Punkt | Angabe |
|---|---|
| Hersteller | Black Forest Labs |
| Offizieller Name | FLUX 3 Image Klein |
| Parameter | 5,6 Mrd. – ausdrücklich nur der Bild-Transformer; der Text-Encoder kommt hinzu [3] |
| Veröffentlichung | 15.10.2026, zweite Open-Weights-Veröffentlichung der FLUX-3-Familie nach FLUX 3 Action [1] |
| Aufgaben in einem Modell | Text-zu-Bild, Editieren per Anweisung, Multi-Referenz mit bis zu 10 Referenzbildern [4] |
| Auflösung | bis 4K (rund 16 MP), 15 Seitenverhältnisse [4] |
| Text-Encoder / VAE | Qwen3-VL-4B-Instruct (Apache-2.0) / flux2-vae (0,3 GB) [4][6] |
| Zugang | Gewichte auf Hugging Face, Repository mit Lizenzannahme freigeschaltet; lokal kein API-Schlüssel nötig [4] |
Bemerkenswert ist weniger die Parameterzahl als der Zuschnitt: Text-zu-Bild, Bearbeiten per Anweisung und Arbeit mit mehreren Referenzbildern sind keine getrennten Werkzeuge mehr, sondern ein Gewichtssatz. Für einen Betrieb heißt das, dass eine Bildsprache mit einem Modell entsteht und nicht aus drei Werkzeugen zusammengesetzt werden muss.
Eine Grenze gehört an den Anfang: Ein kurzer Prompt liefert generisches Ergebnis. Der Hersteller schreibt selbst, dass volle Szenenbeschreibungen nötig sind – Motiv, Position, Umgebung, Lichtrichtung, Kamera [4]. Wer „Bild mit Werkstatt“ eingibt, bekommt ein Klischee. Deshalb stehen unter den drei Beispielen die Prompts im Wortlaut: Sie zeigen den Aufwand, den ein brauchbares Motiv braucht.
Drei Fähigkeiten, drei Bilder
Die drei Beispiele sind bewusst als Test gebaut, nicht als Werbung. Jedes prüft eine Eigenschaft, die sich überprüfen lässt: Schrift, Platzierung, Textur.
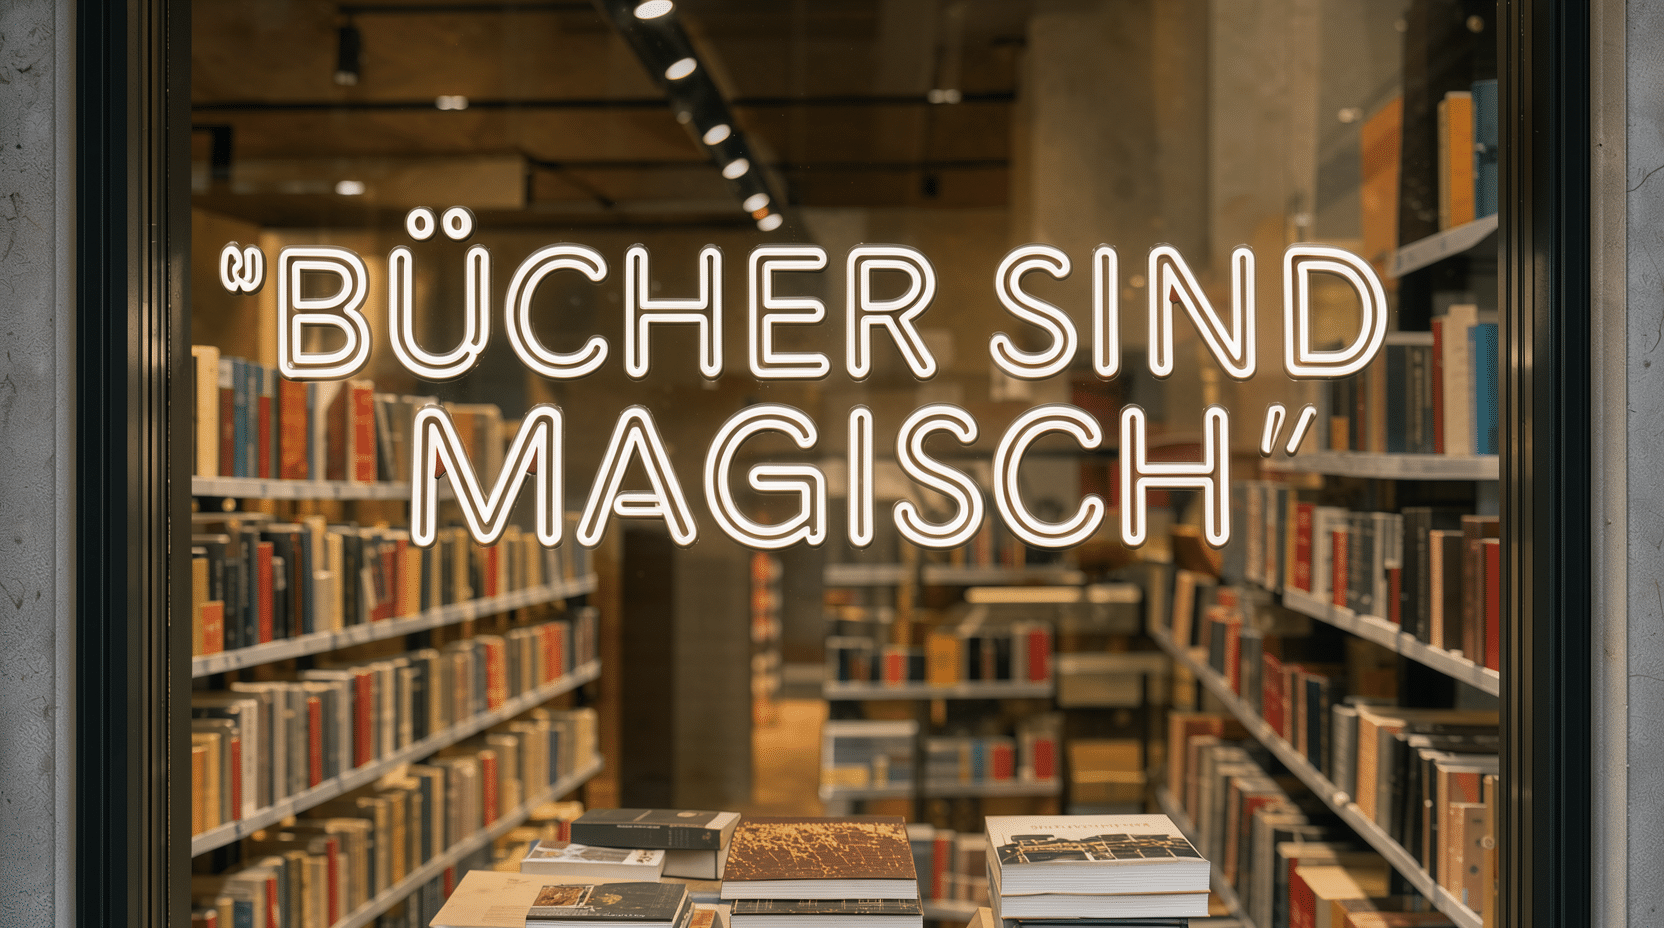
Beispiel 1 – Schrift im Bild. Der Prompt im Wortlaut:
Eine minimalistische Straßenaufnahme eines Schaufensters einer modernen Buchhandlung. Mittig auf die Glasscheibe geschrieben steht in sauberer, weißer Neonschrift der deutsche Satz: ‚BÜCHER SIND MAGISCH‘. Im warm beleuchteten Ladeninneren sind ordentlich gestapelte Bücherregale in sanfter Unschärfe sichtbar.
Das ist der harte Test: deutscher Satz, Großbuchstaben, Umlaut, an einer festgelegten Stelle. In unserem Lauf steht der Satz buchstabengetreu im Bild, einschließlich Ü – maschinell per Texterkennung ausgelesen, nicht nach Augenschein behauptet [15]. Damit ist die Grenze verschoben, die wir in unserem Artikel zur lokalen Bildgenerierung vom 12.10.2026 noch beschrieben haben, als wir Überschriften grundsätzlich außerhalb des Bildes gesetzt haben [13].
Trotzdem bleibt es ein Test und kein Versprechen: Die Modellkarte sagt ausdrücklich, dass erzeugter Text ungenau oder verzerrt ausfallen kann [4]. Für kurze Zeilen in Großbuchstaben trägt das Ergebnis in dieser Größe; für lange Absätze, Kleinschrift und Rechtschreibgarantien ist es das falsche Werkzeug. Unsere Praxis bleibt deshalb zweigeteilt: Text, der exakt sitzen muss, gehört weiterhin ins Layout. Text, der mitten in der Szene stehen soll – Schild, Schaufenster, Poster – ist jetzt machbar.
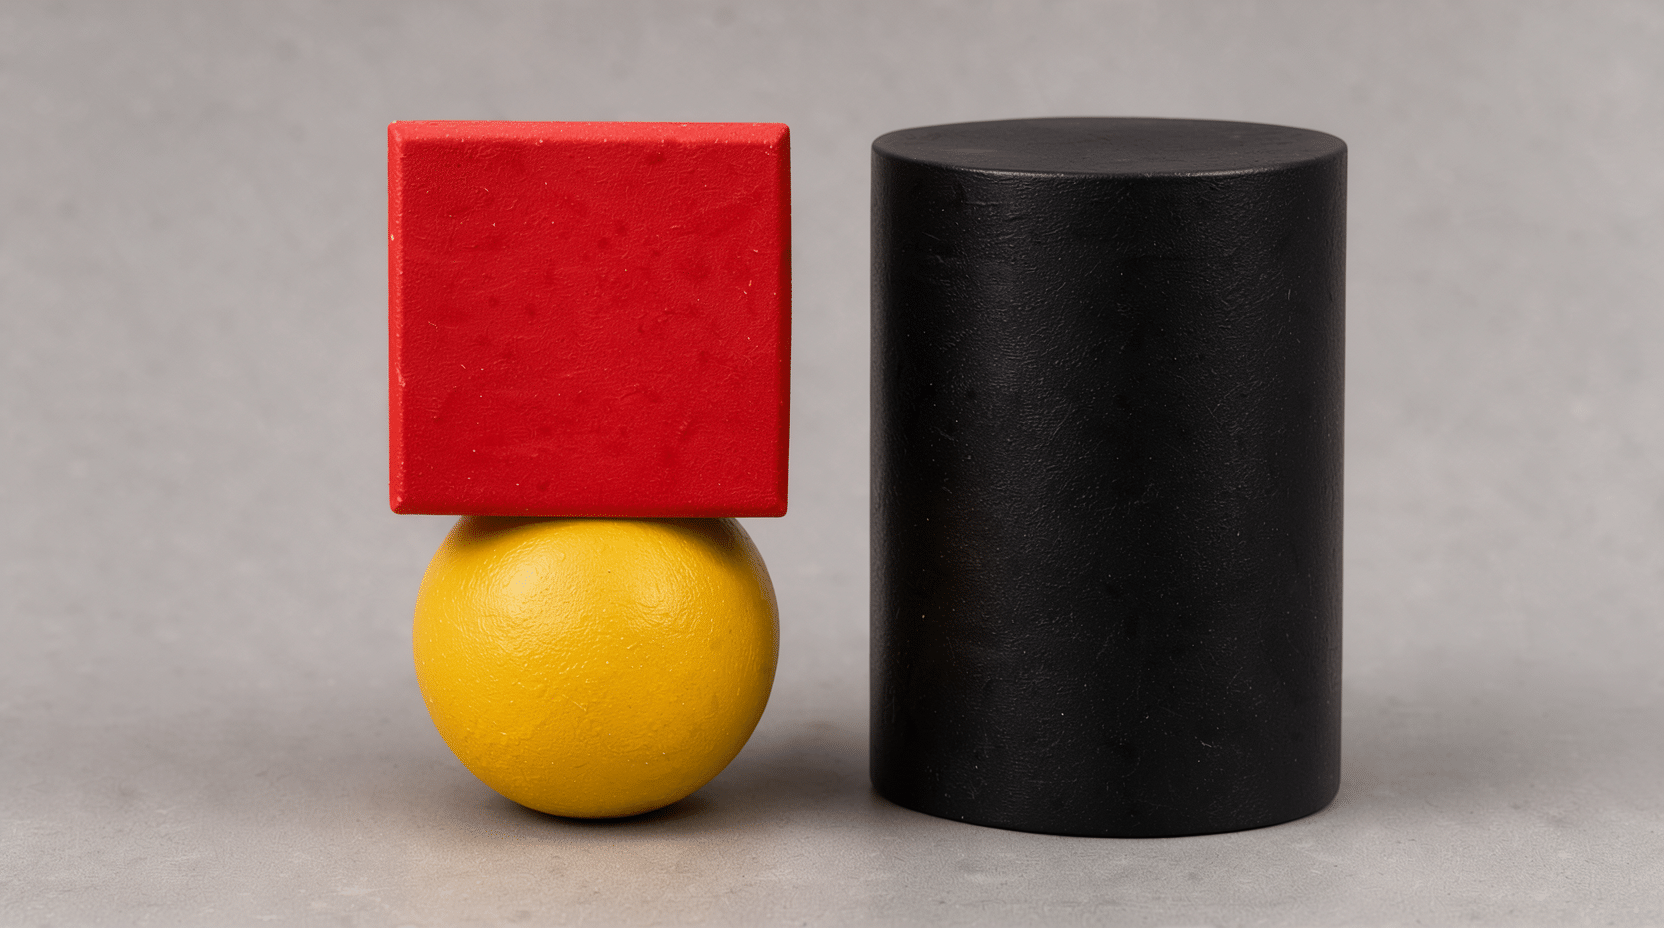
Beispiel 2 – Räumlichkeit und Attribut-Bindung. Der Prompt im Wortlaut:
Ein roter Würfel liegt exakt oben auf einer gelben Kugel. Dieses Gebilde steht streng links neben einem mattschwarzen Zylinder. Klare Studiobeleuchtung, neutraler grauer Hintergrund, maximale Tiefenschärfe.
Dieser Test prüft die Fehlerquelle, die ältere Bildmodelle zuverlässig produziert haben: Farben, die an das falsche Objekt wandern, und Objekte, die ihre Plätze tauschen. Drei Objekte, drei Farben, drei Positionen in einem Satz – daran scheitert ungenaue Sprachsteuerung sichtbar.
Für Betriebe ist diese Fähigkeit der eigentliche Fortschritt, denn sie bringt ein Werkzeug mit, das sich exakt anweisen lässt: Bounding-Boxen. Man gibt dem Modell am Ende des Prompts eine Liste mit Koordinaten mit – je Box oben, links, unten, rechts auf einem Raster von 0 bis 1000 – und bestimmt damit, wo im Bild ein Element steht [4]. Wir nutzen das für Text und Grafiken; in einem eigenen Test kamen zwei so platzierte Textzeilen buchstabengetreu an den vorgegebenen Stellen heraus [15].
Zwei Einschränkungen stehen ausdrücklich in der Herstellerdokumentation und gehören in jede Erwartung: Boxen steuern Platzierung und Größe, aber sie sind keine harte Maske – ein Element darf über seine Box hinausragen, und sehr kleine Elemente können ganz fehlen [4]. Beim Bearbeiten eines vorhandenen Bildes gilt zusätzlich, dass sich Inhalte außerhalb der bearbeiteten Region ändern können [4]. Pixelgenau bleibt damit eine Eigenschaft des API-Wegs, der unveränderte Bildbereiche exakt erhält; lokal ist es eine Annäherung [4]. Was unser Beispiel tatsächlich zeigt – ob der Würfel am Ende auf der Kugel liegt –, beurteilen Sie am Bild. Wir prüfen maschinell Format, Farbanteile und Bildtext; den Blick auf die Szene hat hier kein Programm [15].
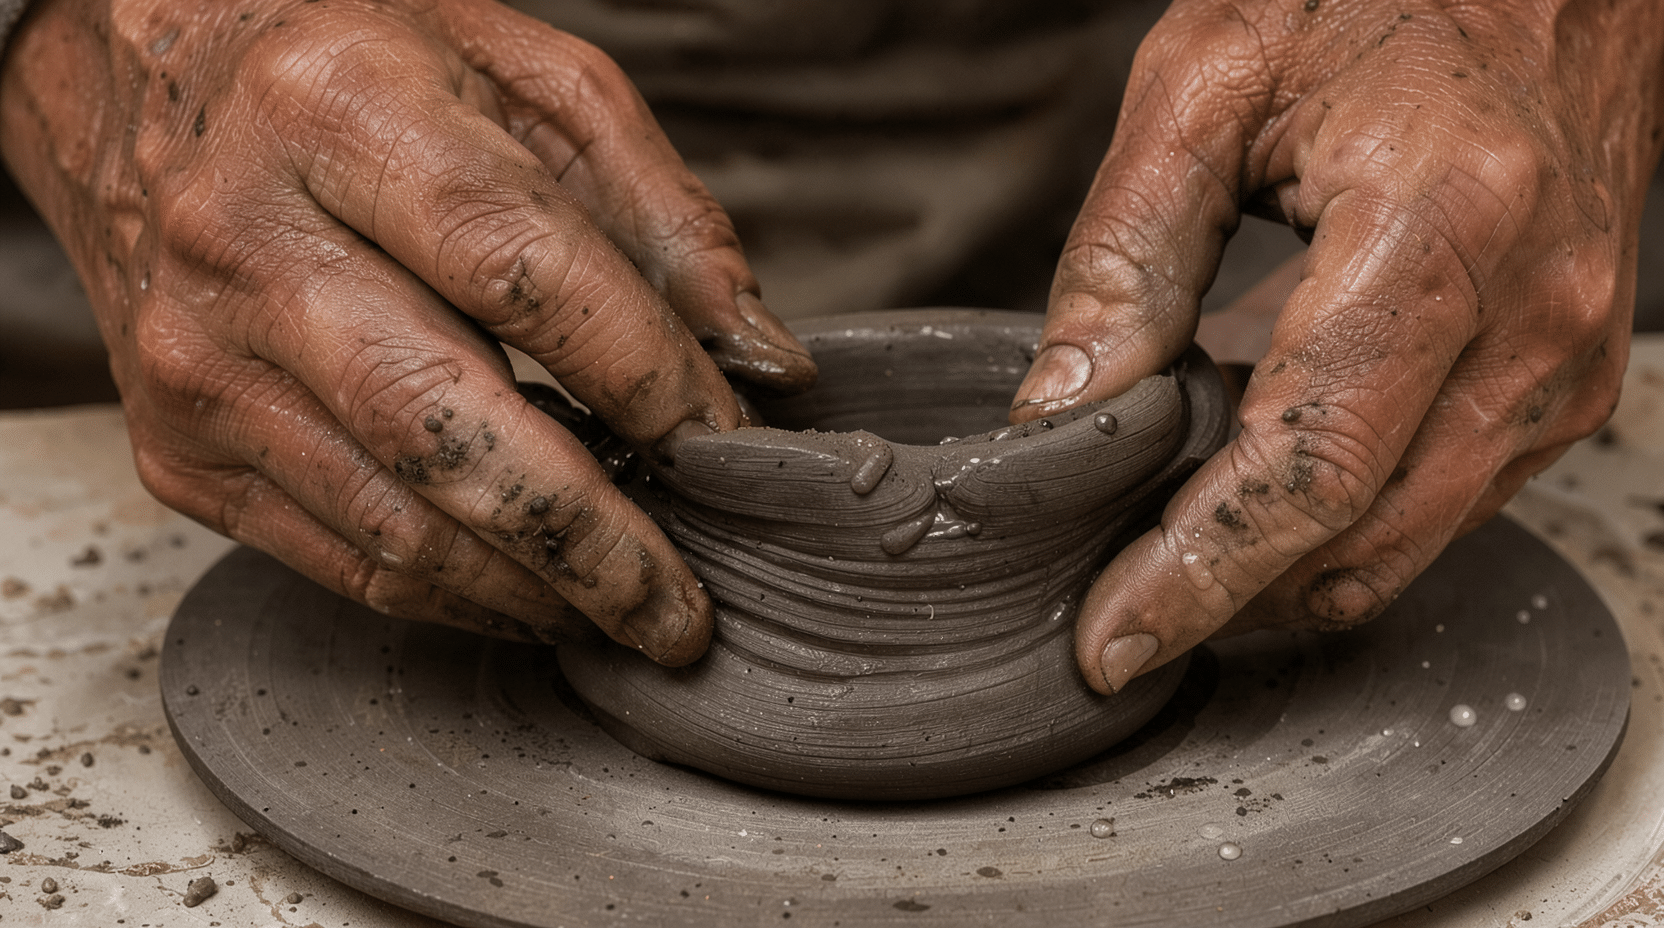
Beispiel 3 – Detailtreue, Texturen und Anatomie. Der Prompt im Wortlaut:
Nahaufnahme der Hände eines älteren Töpfers, der feuchten, dunklen Ton auf einer Töpferscheibe formt. Feine Hautporen, tiefe Falten, antrocknende Tonspritzer auf den Fingerknöcheln, einzelne Wassertropfen, Makroaufnahme, gerichtetes Seitenlicht.
Hände sind der Test, an dem sich Bildmodelle seit Jahren verraten: Fingerzahl, Gelenke, Übergänge. Dazu kommt die Materialfrage – feuchter Ton, der wie feuchter Ton aussieht und nicht wie Plastik. Für Handwerk und Mittelstand ist genau das der praktische Punkt, denn Motive mit Werkzeug, Material und Händen tragen die Bildsprache dieser Branche. Ob das Ergebnis dieser Erwartung standhält, beurteilen Sie am Bild – wir prüfen maschinell, wie oben beschrieben [15].
Ein Hinweis, der für den Einsatz zählt: Auch wenn diese Motive keine Personen zeigen, sind reale Arbeitsszenen mit erkennbaren Gesichtern ein eigener Fall. Bevor ein solches Bild veröffentlicht wird, gehört die Einwilligung der abgebildeten Personen dazu. Das Modell erzeugt diese Frage nicht – es macht sie nur leichter, sie zu übersehen.
Varianten, Dateigrößen, Quantisierung
FLUX 3 Image Klein gibt es in zwei Varianten, und die Wahl hängt am Zweck, nicht am Geschmack. Die Unterscheidung ist auch der Grund, warum zwei Zeitangaben in Umlauf sind.
| Variante | Schritte | Guidance | Zweck |
|---|---|---|---|
| Base (undistilliert) | 50 | 3,5 | Fine-Tuning, LoRA, Forschung |
| distilliert | 16 | 1 / keine | Generierung und Bearbeitung, Self-Hosting; diese Fassung steckt hinter der Hersteller-API [2][4] |
Dazu vier Quantisierungen: BF16, FP8, INT8 und NVFP4, die letzten drei mit Unterstützung von NVIDIA [4]. Die Dateigrößen der ComfyUI-Fassung, wie sie auf der Platte liegen:
| Datei | BF16 | int8 | NVFP4 |
|---|---|---|---|
| Bildmodell (Transformer) | 11,1 GB | 5,8 GB | 5,3 GB |
| Text-Encoder | 8,9 GB | 4,9 GB | – |
| Prompt-Upsampler | – | 9,8 GB | – |
Dazu rund 0,3 GB VAE [6]. Wer rechnet, kommt in der int8-Fassung auf etwa 11 GB Dateien – das ist die Zahl, die im Netz als Speicherbedarf kursiert und die falsch ist.
Zum Umfeld: ComfyUI unterstützt das Modell ab Version 0.41.0 mit fertigen Templates, dazu kommen Diffusers, TensorRT-LLM, SGLang Diffusion und vLLM-Omni; LoRA-Training lief bereits am ersten Tag unter anderem mit dem Ostris AI Toolkit und NVIDIAs NeMo AutoModel [4][5][8]. Ein LoRA-Beispiel des Herstellers nennt Rank 32, 20 Bilder, 4.000 Schritte und rund 4,5 Stunden auf einer GPU [2]. Wer eigene Bildsprache trainieren will, ist damit nicht auf den Hersteller angewiesen.
Eine Randnotiz mit Praxiswert: Der Prompt-Upsampler ist ein separates Modell (Qwen3.5 9B), das kurze Wünsche in volle Szenenbeschreibungen übersetzt [4]. Die API nutzt ihn immer; in ComfyUI ist er für Text-zu-Bild standardmäßig aktiv und für Bearbeitungs-Workflows nicht. Für die drei Beispiele in diesem Text haben wir ihn abgeschaltet, damit der Prompt unverändert ins Modell geht [15]. Beide Wege funktionieren – aber wer den Upsampler abschaltet, muss selbst schreiben.
Grafikspeicher: die Zahl, an der sich die Anschaffung entscheidet
Hier liegt der wichtigste Irrtum dieses Modells. Die Herstellerangabe von „ab 8 GB“ ist keine Aussage über den Bedarf im Betrieb, sondern über eine Quantisierung [1][6]. Die Modellkarte widerspricht der Gleichsetzung ausdrücklich: Die Dateigröße sei kein Maß für den gesamten GPU-Speicherbedarf [4].
Gemessene Werte aus der Referenzimplementierung des Herstellers, 1024 × 1024 Pixel, ohne Upsampler: 31 GB in BF16, 26 GB in FP8, 25 GB in NVFP4; für die Base-Variante 31, 29 und 26 GB. Der Prompt-Upsampler legt auf einer Karte mit 80 GB rund 28 GB obendrauf [4]. Das ist die Größenordnung, in der ein Betrieb rechnen muss, wenn er die Qualitätsstufe ohne Quantisierung fährt.
Die 8 GB stammen aus dem Blog des Herstellers und aus dem ComfyUI-Repository: Der int8-Build läuft dort auf 8-GB-Karten wie der RTX 3070 und auf GPUs ohne FP8-Unterstützung (RTX-30-Serie und älter) [1][6]. NVFP4 setzt Blackwell voraus. Dagegen steht in der Herstellerdokumentation die Angabe „läuft auf Consumer-GPUs, bis hinunter zu einer RTX 3090“ – also 24 GB [4]. Die beiden Angaben widersprechen sich, und eine unabhängige Nachmessung gibt es nicht. Zusätzlich berichtet VentureBeat, der Hersteller habe eine 8-GB-Konfiguration und 4K nicht getestet [7].
Für die Praxis heißt das: „laut Black Forest Labs ab 8 GB VRAM, im int8-Build, bei einer Million Pixel Ausgabe“ ist die belastbare Formulierung – als Herstellerangabe gekennzeichnet und nicht als Messwert. Unser eigener Betrieb liegt darüber: eine Karte mit 24 GB, int8, 1664 × 928 in 6,2 Sekunden [15].
Geschwindigkeit
Die Zahlen des Herstellers, jeweils mit dem schnellsten Build der Karte gemessen, 1 MP in ComfyUI, distilliert und int8: rund 4 Sekunden auf einer RTX 5090 und unter 9 Sekunden auf einer RTX 4070 [1]. Auf Server-Hardware mit NVFP4 nennt der Hersteller unter 0,6 Sekunden für 1 MP [2]. Bei 2 MP liegen die Werte deutlich höher – bis zu 50 Sekunden auf der RTX 4070 [7]. 4K ist in keiner veröffentlichten Messung enthalten [7].
Diese Werte sind Herstellerangaben aus unterschiedlichen Builds und deshalb keine reine Hardware-Rangfolge. Unsere eigenen Messwerte liegen mit 6,2 Sekunden für 1664 × 928 und 12,2 Sekunden für 1920 × 1120 im erwartbaren Bereich – inklusive der Sequenz: Eine Karte trägt einen Lauf gleichzeitig, Aufträge werden gereiht [15].
Die Lizenz: frei heißt hier nicht schrankenlos
FLUX 3 Image Klein steht unter der FLUX Kommunity License v1.0. Die Regelung ist nicht kompliziert, aber sie hat drei Stufen, die in Kurzmeldungen regelmäßig fehlen [9].
Erstens die Umsatzschwelle. Kommerziell nutzen dürfen die Ergebnisse, wer gemeinsam mit verbundenen Unternehmen weniger als 5 Mio. US$ Jahresumsatz macht – die Lizenz nennt das den „Qualifying User“ [9]. Darunter ist die Output-Nutzung kostenlos. Ein Handwerksbetrieb oder ein KMU liegt klar darunter; ein Mittelständler nahe der Schwelle sollte es prüfen, und ein Unternehmen darüber braucht eine kommerzielle Vereinbarung.
Zweitens die Auflagen, die mit dem Vorrecht kommen. Wer als Qualifying User Output kommerziell nutzt, muss nach §2.e entweder einen Content-Filter betreiben oder die Ergebnisse vor der Verbreitung auf rechtswidrige und verletzende Inhalte prüfen lassen – und die Ergebnisse dort, wo es gesetzlich gefordert ist, als KI-erzeugt oder -verändert kennzeichnen [9]. Das ist die Pflicht, die in der Praxis zuerst greift, nicht die Umsatzschwelle.
Drittens die Grenze des Vorrechts. Die Lizenz erlaubt keine pauschale kommerzielle Freiheit: Die Modellkarte schreibt ausdrücklich, die Ausnahme sei keine Blankogenehmigung für kommerzielles Fine-Tuning oder die Weitergabe des Modells [4]. Der Hersteller verlangt für den Einsatz des Modells in einem Produkt eine kommerzielle Lizenz und beschreibt dafür Selbst-Hosting-Pakete, in deren Listen das Modell namentlich geführt wird; Preise nennt er nicht öffentlich [4][11][7]. Wer damit ein eigenes Produkt baut oder Kunden Zugriff darauf gibt, ist nicht mehr im kostenlosen Bereich. Eigentum an den erzeugten Bildern beansprucht der Hersteller nicht [9].
Sektion 4 der Lizenz verbietet eine Reihe von Verwendungen, darunter militärische Nutzung, Überwachung, biometrische Verarbeitung, rechtswidrige oder verleumderische Inhalte, die Verletzung von Persönlichkeits- und Digital-Replica-Rechten und die Nutzung der Ergebnisse zum Training eines funktional ähnlichen Modells [9]. Der Lizenztext adressiert ausdrücklich die DSGVO und den EU AI Act.
Unser Fazit nach der Prüfung, offen gesagt: Die Lizenz ist für Content-Produktion tragfähig und für Produktbau ein Kostenpunkt. Der Text-Encoder (Qwen3-VL-4B) und der Prompt-Upsampler stehen unter Apache 2.0 – die Kommunity-Lizenz gilt für die Gewichte des Bildmodells, nicht für das ganze Paket [4][6].
Wenn Sie nicht selbst hosten: der API-Weg
Nicht jeder Betrieb will eine Karte einrichten und pflegen. Derselbe Hersteller bietet das Modell auch als Dienst an – allerdings nur die distillierte Fassung [4]:
| Auflösung | 768 × 768 | 1K | 1,5K | 2K | 4K |
|---|---|---|---|---|---|
| Preis je Bild | 0,008 US$ | 0,009 US$ | 0,011 US$ | 0,014 US$ | 0,036 US$ |
Dreifach deckungsgleich aus Dokumentation, Modellseite und Preisseite; Text-zu-Bild und Bearbeiten kosten gleich viel [4][10][12]. Zum Vergleich: Für die große Fassung derselben Familie nennt der Hersteller 0,048 US$ je Bild in 1K, für Wettbewerberprodukte 0,03 US$ und 0,0336 US$ [7]. Die API ruft das Modell über einen Endpunkt auf, ein Schlüssel im Header, Ergebnis per Abfrage abholbar [4].
Zwei praktische Unterschiede zum eigenen Betrieb sind wichtig. Erstens macht die API das Prompt-Upsampling immer, und zweitens liefert sie beim Bearbeiten eine Pixel-Restoration, die unveränderte Bildbereiche exakt erhält – die lokale Fassung garantiert das nicht [4]. Dafür läuft bei der API jede Bildbeschreibung über einen fremden Server. Wer Motive aus dem eigenen Betrieb erzeugt, entscheidet mit dem Weg auch darüber, wohin diese Beschreibung geht.
Eine Warnung gegen eine häufige Verwechslung: Auf der Preisseite des Herstellers steht daneben ein „Klein 4B“ mit Megapixel-Preis. Das ist ein anderes, älteres Modell aus der FLUX-2-Reihe und nicht dieses [10].
Was wir empfehlen – und was nicht
Für wiederkehrende Bilder in Serie: lokal, mit diesem Modell. Artikelbilder, Stellenanzeigen, Angebotsköpfe, Beitragsbilder, Schilder und Poster in einer gleichbleibenden Bildsprache, ohne dass ein Motiv das Haus verlässt und ohne Zähler, der bei jedem Bild weiterläuft. Die Maschine ist ohnehin da und trägt weitere Aufgaben; die Fixkosten verteilen sich, und der Betrieb bleibt unabhängig von Preis- und Modelländerungen eines Anbieters. Die Lizenzlage ist für diese Nutzung geklärt, wenn Sie unterhalb der Umsatzschwelle liegen und die Kennzeichnung ernst nehmen.
Für einzelne Bilder im Monat: der Dienst. Fixkosten von Hardware plus Einrichtung plus Pflege rechnen sich nicht gegen gelegentliche Nutzung. Das gilt weiterhin unverändert, auch für ein Modell mit dieser Qualität.
Für den Produktbau: erst Lizenz, dann Technik. Wer das Modell in ein eigenes Produkt einbaut oder Kunden Zugriff darauf gibt, braucht eine kommerzielle Vereinbarung – unabhängig davon, wie gut die Ergebnisse sind. Diese Prüfung gehört vor die erste Zeile Code.
Nicht empfehlen wir, aus den Hersteller-Ranglisten eine Marktführerschaft abzuleiten. Die veröffentlichten Vergleiche sind interne Blindtests des Herstellers ohne offengelegte Stichprobe, und eine unabhängige Nachmessung liegt uns nicht vor [7]. Ein Elo-Wert sagt nichts über die Eignung für Ihr Motiv.
Compliance: die zwei Pflichten, die mit der Lizenz kommen
Die Lizenz verlangt eine Prüfung der Ergebnisse vor der Verbreitung oder einen Content-Filter, und sie verlangt die Kennzeichnung als KI-erzeugt, wo das Gesetz sie fordert [9]. Dazu kommt die Kennzeichnungspflicht für synthetische Inhalte aus Artikel 50 der Verordnung (EU) 2024/1689: Anbieter müssen Ausgaben maschinenlesbar kennzeichnen, Betreiber müssen offenlegen, dass Inhalte künstlich erzeugt oder bearbeitet wurden, wenn sie als täuschend erscheinen können. Ausgenommen sind offensichtlich künstlerische, satirische und redaktionell geprüfte Inhalte, für die eine Person die Verantwortung übernimmt [14]. Bei uns ist die Kennzeichnung ein fester Schritt der Veröffentlichung, keine Fußnote.
Und der Satz, der in keinem Anbietertext steht: „lokal“ ist eine Eigenschaft der Verarbeitung, keine Datenschutzgarantie. Läuft die Generierung auf eigener Hardware in einem abgeschotteten Netzsegment, findet keine Übermittlung an Dritte statt – das ist eine technische Feststellung. Ob ein konkreter Einsatz rechtmäßig ist, hängt am Zweck, an den verwendeten Daten und an der Rechtsgrundlage, und damit an Ihrer Bewertung und nicht am Werkzeug. Wer lokale Bildgenerierung als „automatisch DSGVO-konform“ verkauft, verkauft eine Behauptung [13].
Was nicht belegt ist
Zu jeder Zahl gehört die Angabe, wie belastbar sie ist:
- Der Mindest-Grafikspeicher ist in den Herstellerquellen widersprüchlich: 8 GB im Blog und im ComfyUI-Repository für den int8-Build gegen „bis hinunter zu einer RTX 3090“ in der Dokumentation. Wir geben beide Angaben weiter und keine eigene Messung für 8 GB – unsere Maschine hat 24 GB [1][4][6].
- Der gemessene Spitzenbedarf von 31 / 26 / 25 GB stammt aus der Referenzimplementierung auf einer B200 und aus der Modellkarte, nicht aus unserer Messung [4].
- 4K ist spezifiziert, aber in keiner veröffentlichten Messung enthalten – weder Zeit noch Speicherbedarf [4][7].
- „Pixelgenau“ gilt für den API-Weg mit Pixel-Restoration. Für die offenen Gewichte nennt die Modellkarte die Einschränkung, dass sich Inhalte außerhalb der bearbeiteten Region ändern können [4].
- Die Beispiele zeigen Ergebnisse unseres Laufs am 15.10.2026. Sie sind kein Nachweis, dass Text, Platzierung oder Details reproduzierbar gelingen – die Modellkarte nennt Text ausdrücklich als fehleranfällig [4].
- Qualitätsranglisten sind interne Evaluationen des Herstellers, nicht unabhängig reproduziert [7].
- Die Lizenzangaben sind eine Lesehilfe, keine Rechtsberatung. Umsatzschwelle, Kennzeichnungspflicht und die Frage, ob Ihr Einsatz eine kommerzielle Vereinbarung braucht, klären Sie im Zweifel mit Ihrer Rechtsberatung.
- Die Seitenverhältnisse unserer eigenen Bilder (1920 × 1120 und 1664 × 928) sind Vielfache von 16 und damit zulässige Formate, aber keine Herstellerempfehlung.
Wenn bei Ihnen regelmäßig Bilder entstehen – Artikelbilder, Stellenanzeigen, Angebotsköpfe, Beitragsserien – oder wenn Sie wissen wollen, ob eine eigene Maschine sich für Ihren Fall trägt: Wie viele Motive brauchen Sie im Monat, und wofür? Schreiben Sie uns zwei Sätze dazu. Sie bekommen eine ehrliche Einschätzung, ob lokal oder Dienst der richtige Weg ist, welche Lizenzstufe für Sie gilt und was vorher zu klären ist. Und eine klare Absage, wenn Ihr Bedarf zu klein für eigene Hardware ist.
Quellen
Alle Angaben stammen aus Adressen, die am 15.10.2026 abgerufen und auf Abrufbarkeit geprüft wurden. Modellstände, Preise und Messwerte sind Momentaufnahmen dieses Tages.
- https://bfl.ai/blog/flux-3-image-klein – Black Forest Labs, Blog zur Veröffentlichung von FLUX 3 Image Klein (Datum 15.10.2026; 5,6 Mrd. Parameter; int8 auf 8-GB-Karten; Messwerte 1 MP)
- https://bfl.ai/models/flux-3-image-klein – Black Forest Labs, Modellseite (distillierter Checkpoint hinter der API; NVFP4 unter 0,6 s auf GB300; LoRA-Beispiel Rank 32 / 20 Bilder / 4.000 Schritte / 4,5 h)
- https://huggingface.co/black-forest-labs/flux-3-image-klein – Model-Card, distillierter Checkpoint (5,6 Mrd. Parameter nur für den Bild-Transformer; Peak-GPU-Speicher; Limitationen zu Text, Bearbeitungsregion und Lizenzumfang)
- https://docs.bfl.ml/flux_3/flux3_image_klein – Black Forest Labs, Dokumentation zu FLUX 3 Image Klein (Spezifikationen, Varianten, Auflösungen, Bounding-Boxen, Prompt-Upsampler, Client-Referenzen, Lizenzhinweise)
- https://docs.bfl.ml/flux_3/flux3_image_overview – Black Forest Labs, Übersicht FLUX 3 Image (API-Parameter, Grenzen, Pixel-Restoration)
- https://huggingface.co/black-forest-labs/flux-3-image-klein-comfy – ComfyUI-Fassung auf Hugging Face (Dateiliste und Größen, int8 auf 8 GB und RTX-30-Serie, ComfyUI-Anforderung ≥ 0.41.0)
- https://venturebeat.com/technology/black-forest-labs-opens-flux-3-image-klein-weights-with-free-commercial-use-limited-to-smaller-businesses – VentureBeat, 15.10.2026 (unabhängige Einordnung; 8-GB- und 4K-Konfiguration laut Hersteller nicht getestet; Vergleichspreise; interne Evaluationen)
- https://docs.comfy.org/tutorials/flux/flux-3-klein – ComfyUI-Dokumentation, Workflow-Tutorial (Schritte, Guidance, Templates)
- https://huggingface.co/black-forest-labs/flux-3-image-klein/blob/main/LICENSE.md – FLUX Kommunity License v1.0 (§1.e Qualifying User unter 5 Mio. US$; §2.a kommerzielle Output-Nutzung; §2.d kein Eigentum an Ergebnissen; §2.e Content-Filter/Prüfung und Kennzeichnung; §3.b Attributionshinweis bei Weitergabe der Gewichte; §4 verbotene Nutzungen)
- https://docs.bfl.ml/quick_start/pricing – Black Forest Labs, Preisliste der API (Preise je Bild und Auflösung; Verwechslungsfalle „Klein 4B“ = FLUX.2 [klein] 4B)
- https://bfl.ai/licensing – Black Forest Labs, Lizenzierung für Selbst-Hosting (Pakete Builder, Platform, Professional, Enterprise; FLUX 3 Image Klein namentlich gelistet)
- https://openrouter.ai/black-forest-labs/flux-3-image-klein – OpenRouter, Modellseite (Erscheinungsdatum 15.10.2026, Preisspanne 0,008 bis 0,036 US$ je Bild)
- https://www.ren-ai-ssance.de/2026/10/12/lokale-bildgenerierung-welche-bild-ki-wirklich-auf-ihrem-rechner-laeuft/ – eigener Artikel vom 12.10.2026 (Lizenzklassen, Kosten, Text-im-Bild-Grenze, Datenhoheit ohne pauschale Datenschutzgarantie)
- https://ai-act-service-desk.ec.europa.eu/de/ai-act/article-50 – AI Act Service Desk der EU-Kommission, Artikel 50 der Verordnung (EU) 2024/1689 (Kennzeichnung und Offenlegung synthetischer Inhalte)
- Eigene Messung und Praxis: fünf Läufe am 15.10.2026 mit FLUX 3 Image Klein über ComfyUI (1664 × 928 in 6,2 s, 1920 × 1120 in 12,2 s, int8, 16 Schritte, Karte mit 24 GB, Aufzeichnung ohne Prompt-Upsampler; Texterkennung im Bild per lokalem OCR-Modell ausgelesen) sowie Bounding-Box-Test vom 15.10.2026
Autor: Team REN-AI-SSANCE – mit KI-Unterstützung erstellt, von Menschen geprüft und freigegeben.